Това е една от най-безсмислените графики, които съм правил, но и едно от най-интересните проучвания. Най-безсмислена е, защото всеки може да ти каже резултата от нея и без проучване – от първокласници до геостратезите в кварталните кръчми или президенството. Защото нещата просто били така.
Но когато, дори и да нямаш опит в лингвистиката, разгледаш езика под повече от един ъгъл, започваш да виждаш думите не само като поредица от букви, а като ДНК поредица на култура И говорейки за култура, българският език е много подходях за такъв анализ – народ, наречен на степно, тюрско по произход племе, заселило се на земя със стабилна и древна трако-византийска основа, но приел езика на неконсолидирана група, която разселили, като жив щит/охрана по границата. Три различни пласта, наслоили се върху различни сфери на живота, топонимията и религията.
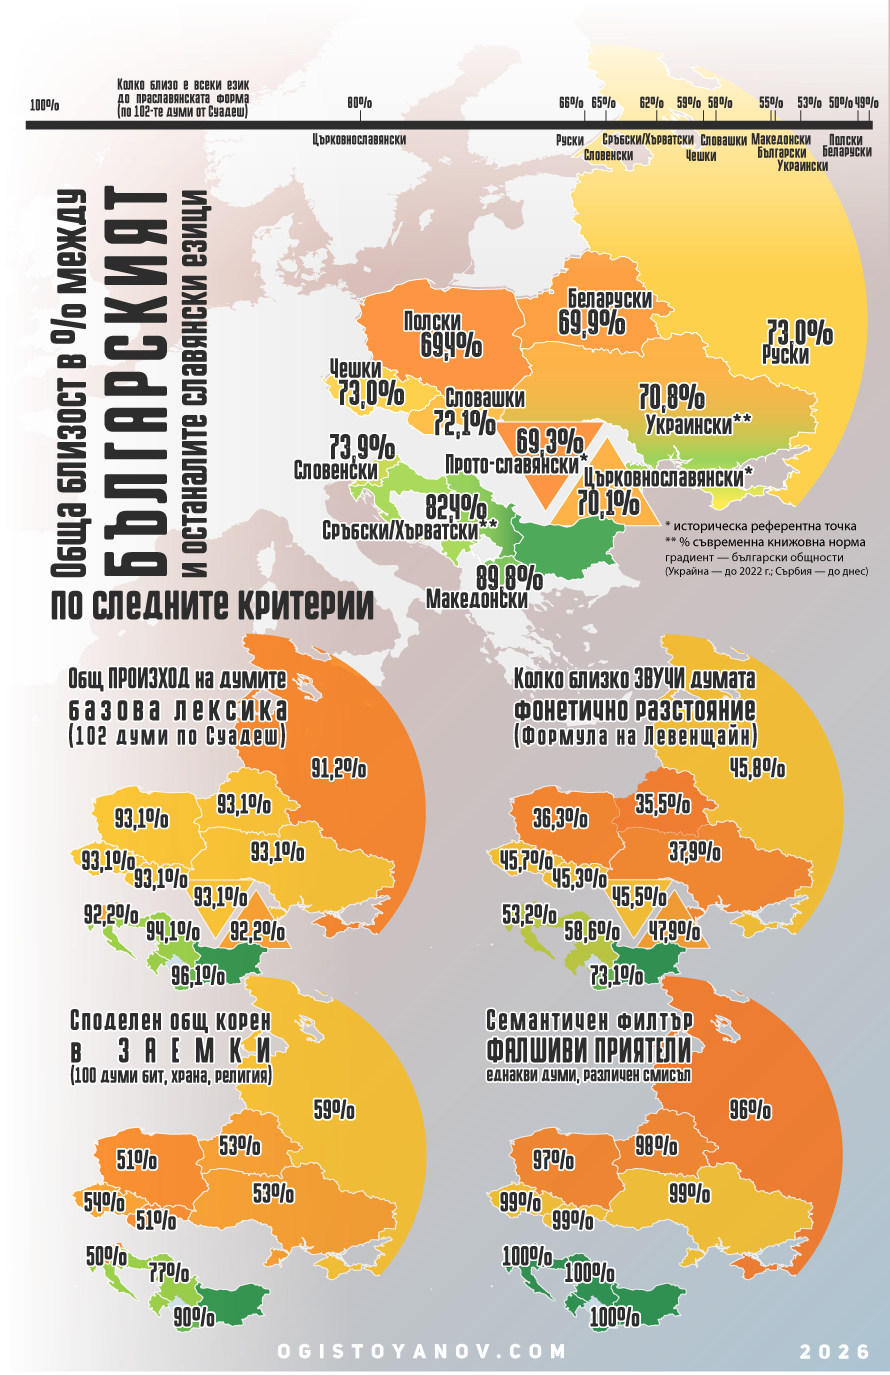
В тази иконографика са включени 4 параметъра по които е измерена близоста на българският с останалите славянски езици.
Първият е общият произход на думите. Това за което повечето хора говорейки за славянските езици имат предвид. За изчисляването на стойностите е използван списък със 100-думи базова лексика (местоимения, числа, части на тялото, природа, основни глаголи), който е устойчив на заемки и е стандартният инструмент в лексикостатистиката. Това е по списък известен като Списък Суадеш и е стандартизиран не само за славянските, а и за други езици. Формите са взети от сравнителната таблица на Proto-Slavic reflexes в славянските езици, с латинска транслитерация за директна съпоставимост. Но е хубаво да се знае, че Суадеш има няколко обемни формата, и аз съм използвал най-малкият, т.е. с друг набор, може да се изведът по точни и по-различни %.
Левенщайн или колко близко звучи думата е % на нормализираната близост (не суровото разстояние) — за всяка от 100-те думи взимам 1 − разстояние/дължина_на_по-дългата_дума и осреднявам за целия език. Резултатите изглеждат логични лингвистично: македонски и сръбско-хърватски като най-близки южнославянски съседи излизат най-близо по форма, а украинският и полският — най-далеч по чиста фонетична форма, макар примерно украинският да е сравнително близък граматически и лексикално. Тук също се използваха думите от списъка на Суадеш.
И тъй като този списък е единственият който можеше да даде някакви резултати за Прото-славянския и Църковнославянският, те присъстват само в графиките по тези два критерия. А са включени за да обяснят някои географски аномалии в процентите (включително при критериите, където липсват) и затова ѝ са посочени с триъгълници „сочещи“ в определени посоки на пренос. Има много добра статия в Wikipedia за този пренос и калките (виж по-долу) и как в различните епохи пътуват към един език, а после наобратно.
Третият и четвъртият параметър обаче разказват съвсем друга история. Проблемът със Списъка на Суадеш е, че е нарочно подбран да устои на заемки — затова изобщо работи за лексикостатистика. Значи, ако искаш да видиш турското и гръцкото наследство на българския спрямо останалите славянски езици, той е абсолютно грешният инструмент — дава плоски, почти неразличими 90-98% навсякъде, все едно българският изобщо не е минал през 500 години на съвсем различна езикова среда.
Затова направих втори, „анти-Суадеш“ списък — 100 думи, но този път нарочно от сферите, в които заемките процъфтяват най-много (бит, кухня, облекло, роднинство, администрация, религия, пазар и не аз го измислих, просто зададох на AI търсачката да ми състави списък от най-използваните в тези сфери български думи). И наистина се оказа анти-Суадеш: В Общ корен от заемки от 50% до 90%, като македонският и сръбско-хърватският рязко изскачат напред (77-90%), защото делят с нас същия османски пласт (чорба, кукер, ракия, чаршия), докато чешкият или словашкият просто нямат тези думи изобщо. В руският също, но той се нарежда трети. Тук обаче причината е същата заради която добавих Църковнославянският — през 10-15 век той е повлиял на църковният румънски (още една добра идея за съпоставка), украинският и руският, а през Възраждането, та до днес най-вече руският връща заемки в българският.
Семантичният филтър е може би най-забавната колона за мен лично, въпреки че картата изглежда прекалено обикновенна. Това е защото не пита „имате ли същата дума“, а „имате ли същата дума с различен смисъл“. И там се откриват неочаквани „фалшиви приятели“ дори от използваните списъци – неделя, жито, закон и така нататък. Но наистина няма как да е по-широк спектъра % освен, ако не се направи нарочен списък, който обаче ще засегне конкретен таргетиран език, дори ако се прави за диалекти.
Ето тук са таблицата с резултатите, както и използваните списъци – Суадеш и анти-Суадеш. И както казах по-горе с различни списъци, особено свити до 100-200 думи в море от стотици хиляди резултатите ще са винаги различни. Въпроса е кои сте готови да приемете и на какво основание, независимо дали сте ученик или геостратег в президенството…